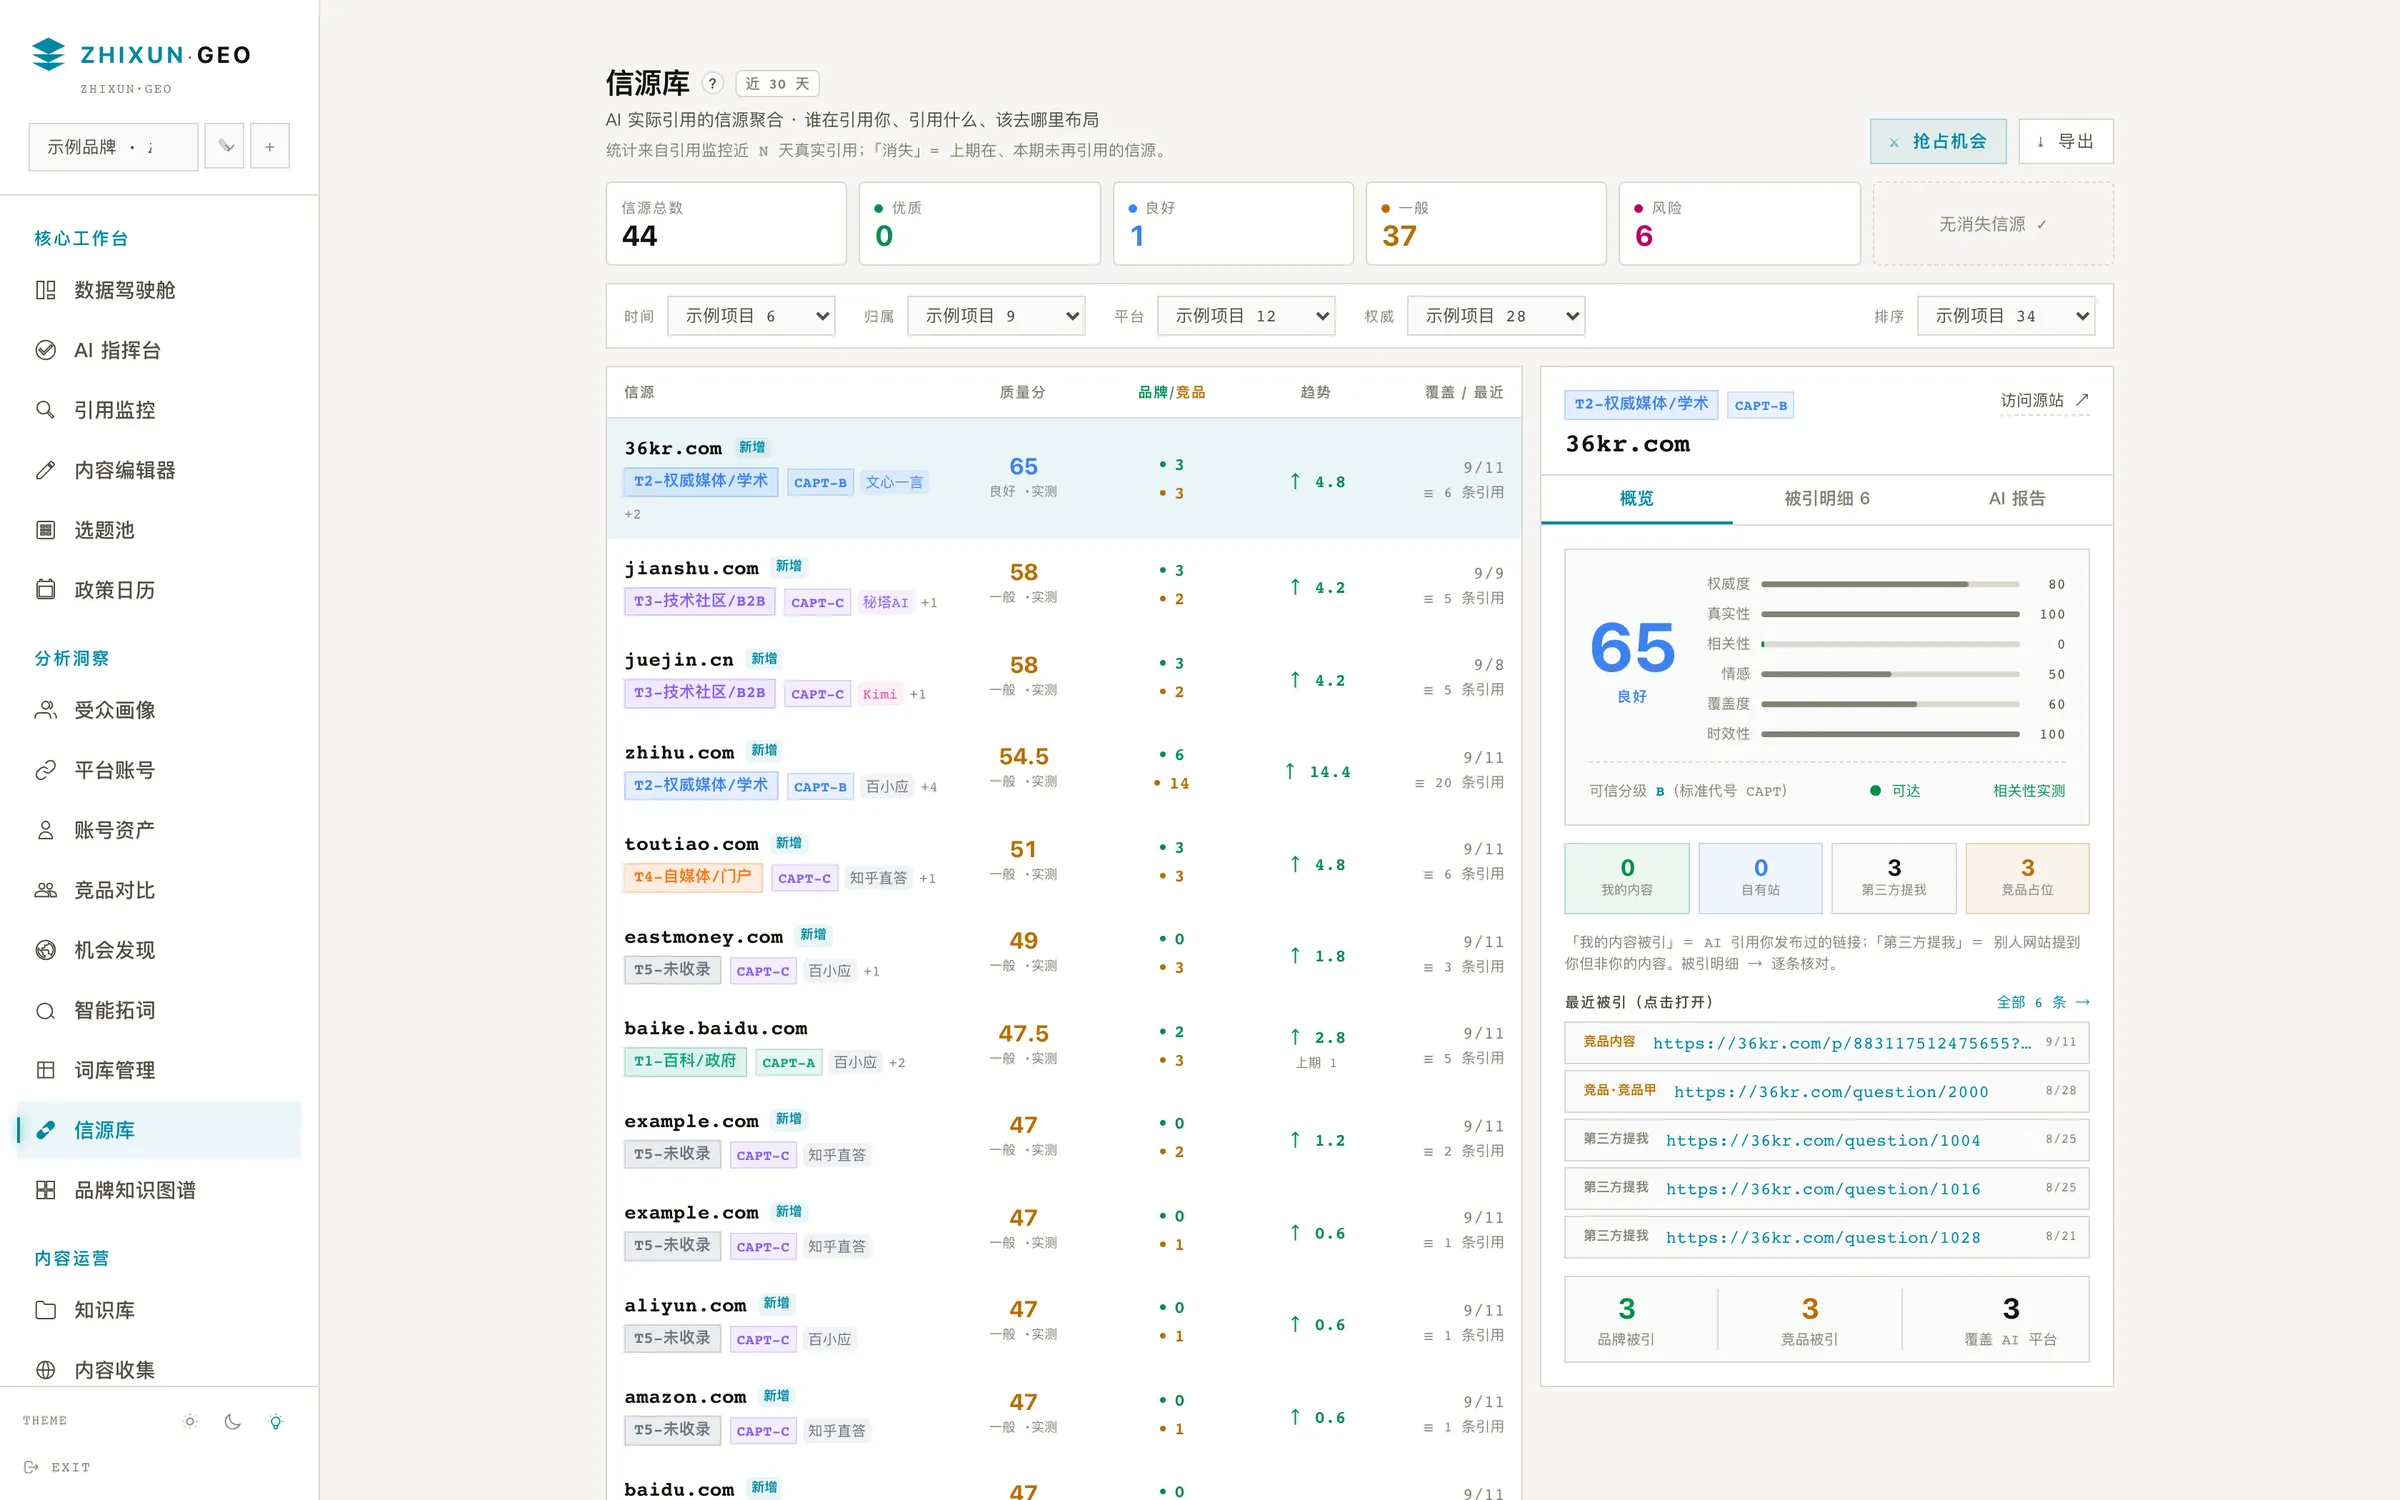
信源库里每一行,都是 AI 真的引用过你
不是「你上传链接我来统计」,而是「AI 没引用过,这里就不会有」
行业普遍做法
行业中常见的做法,是让运营上传或录入一批「我发过哪些文章」的链接清单,系统按链接数量、平台分布、发布频次做统计与呈现,看板做得很漂亮;但准确性完全依赖人工维护,链接有没有被 AI 真正引用通常不在统计口径内,也很少逐条去读被引页面的正文做校验。
知寻 GEO 做法
信源库只做聚合、不做录入:四个接口全部是只读查询,聚合、明细、缺口、报告都没有上传链接的入口,库里每一行都只从 citations 表中「真被引用过且带来源网址」的记录来;再按权威度、真实性、相关性、情感、覆盖度、时效性六维加权算分并划分等级,相关性还区分实测与代理。
补充:六维信源质量里「相关性」是真去读那篇文章——打标 measured / proxy,不把模型猜的当实测(“分数可以低,但必须知道它是怎么来的”)。
一份「造不了假」的信源台账,才配叫做资产。
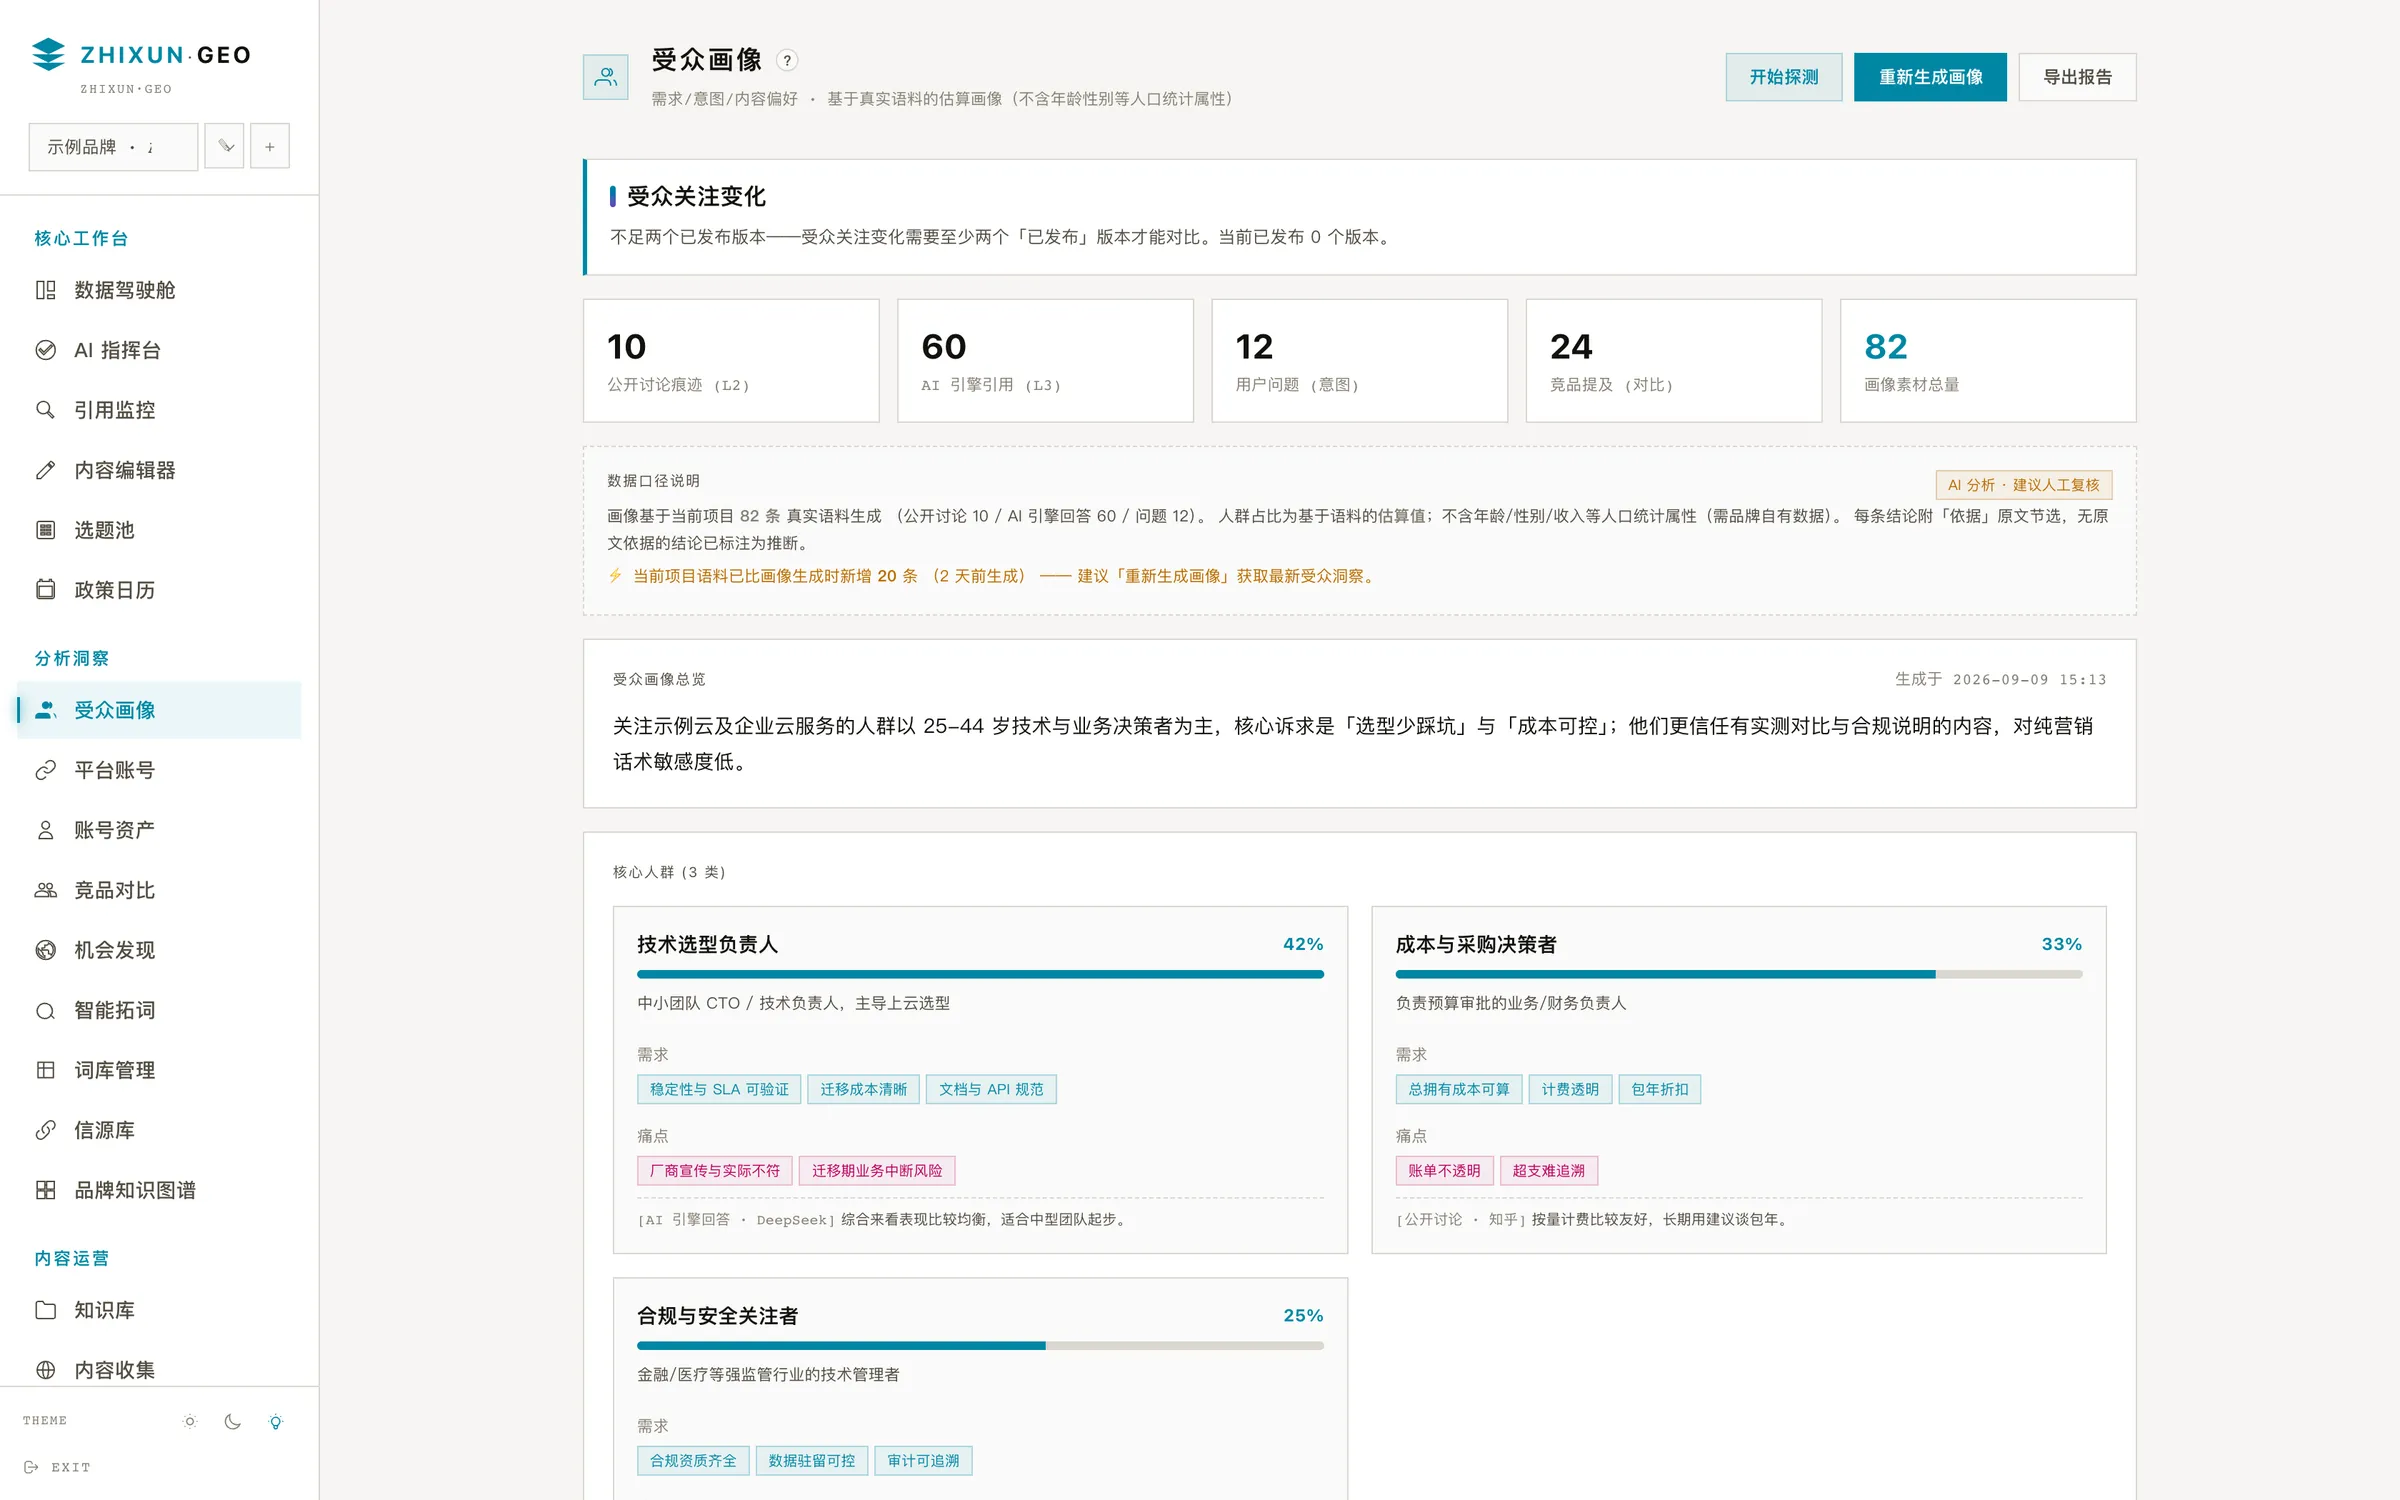
受众画像不是「分析你给的数据」,是主动去问 AI
用问题模板主动探测 AI 引擎,反向挖出「关注这个品类的人到底在问什么」
行业普遍做法
依赖客户已有的客户管理系统、问卷或社媒后台数据,有什么数据就分析什么;没有存量数据就没有画像,常见替代做法是按年龄、性别、地域等人口统计维度切人群包,结论来自存量数据的二次加工,而不是主动去问 AI,也拿不到 AI 回答里的原话;这类画像往往只覆盖已有客户,对新客与潜在需求几乎是盲区。
知寻 GEO 做法
用固定问题模板主动探测 AI 引擎:由品牌词生成「怎么样、靠谱吗、和竞品怎么选、收费贵吗、有什么坑、擅长什么领域」等问题,经七个 API 引擎并行提问,回答原样入库并单独标记为探针语料,再反向聚类出需求、意图与内容偏好;画像读取全部语料(含探针),全系统其他统计口径统一排除探针,避免自己抬高自己的可见度。
补充:每条结论都带证据,缺证据就标「推断」——核心结论逐条附 1–3 条证据并可回溯原始语料。
不问 AI,你永远不知道客户在 AI 面前是怎么描述你的。
被用户喜欢的内容,可以变成 AI 会引用的信源
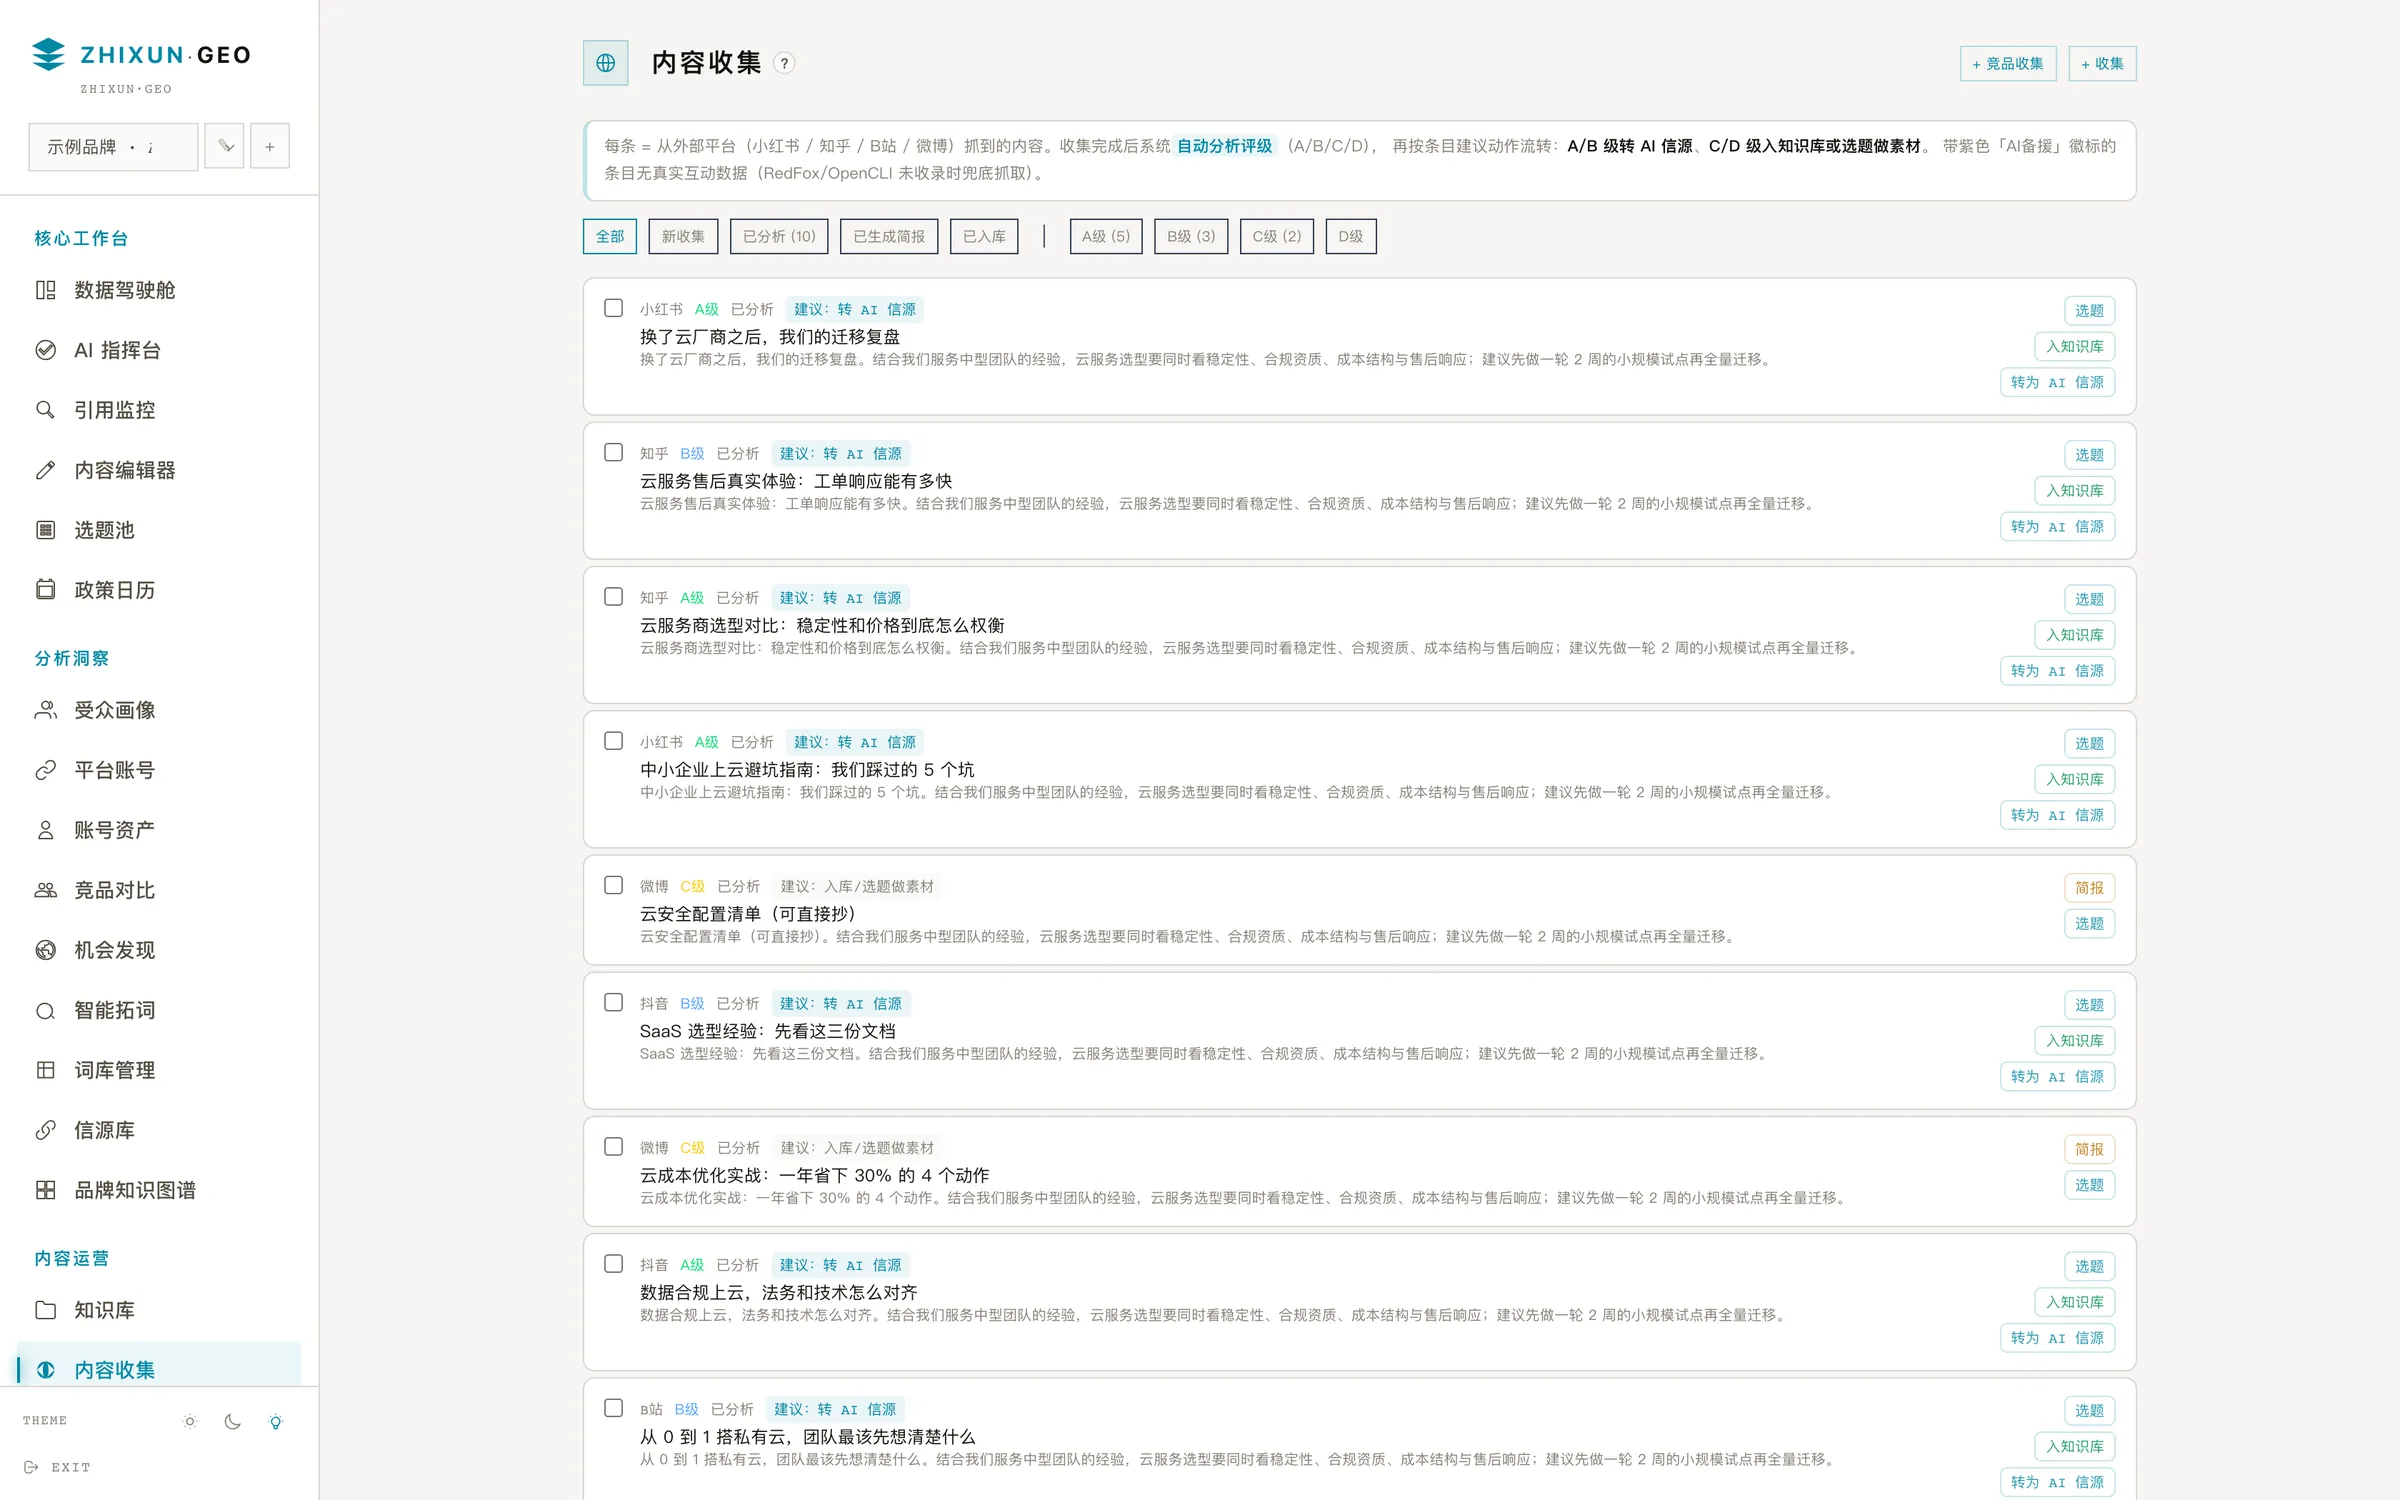
收集不只是「存档」,而是带质量门控的资产转化
行业普遍做法
把内容收集做成参考素材库:抓回来、存起来、按平台分好类,供选题时翻看参考;内容好不好主要靠运营人工判断,没有统一的评分口径;收集行为与后续的内容生产、发布、引用监测之间也没有打通,素材始终停在「参考」这一层,说不清哪条内容真的换来了 AI 引用。
知寻 GEO 做法
每条收集内容自动按十个维度评分(引文密度、来源标注、数据密度、内容结构、问答区块、权威度、语义对齐、域名权威、新鲜度、答案前置,满分一百,权重公开),划为 A 至 D 四级;只有 A、B 级允许转化,转化时注入真实点赞评论分享数、补齐问答结构化,并同步产出内容、发布任务、引用监控三件套。
补充:采用 10 维带权重的内容评分(满分 100,权重公开),只有 A、B 级才允许转为 AI 信源,转化时同步补结构化标记。
别人收集内容是为了参考,我们收集内容是为了让 AI 引用你。
采不到数据不可怕,采错数据才可怕
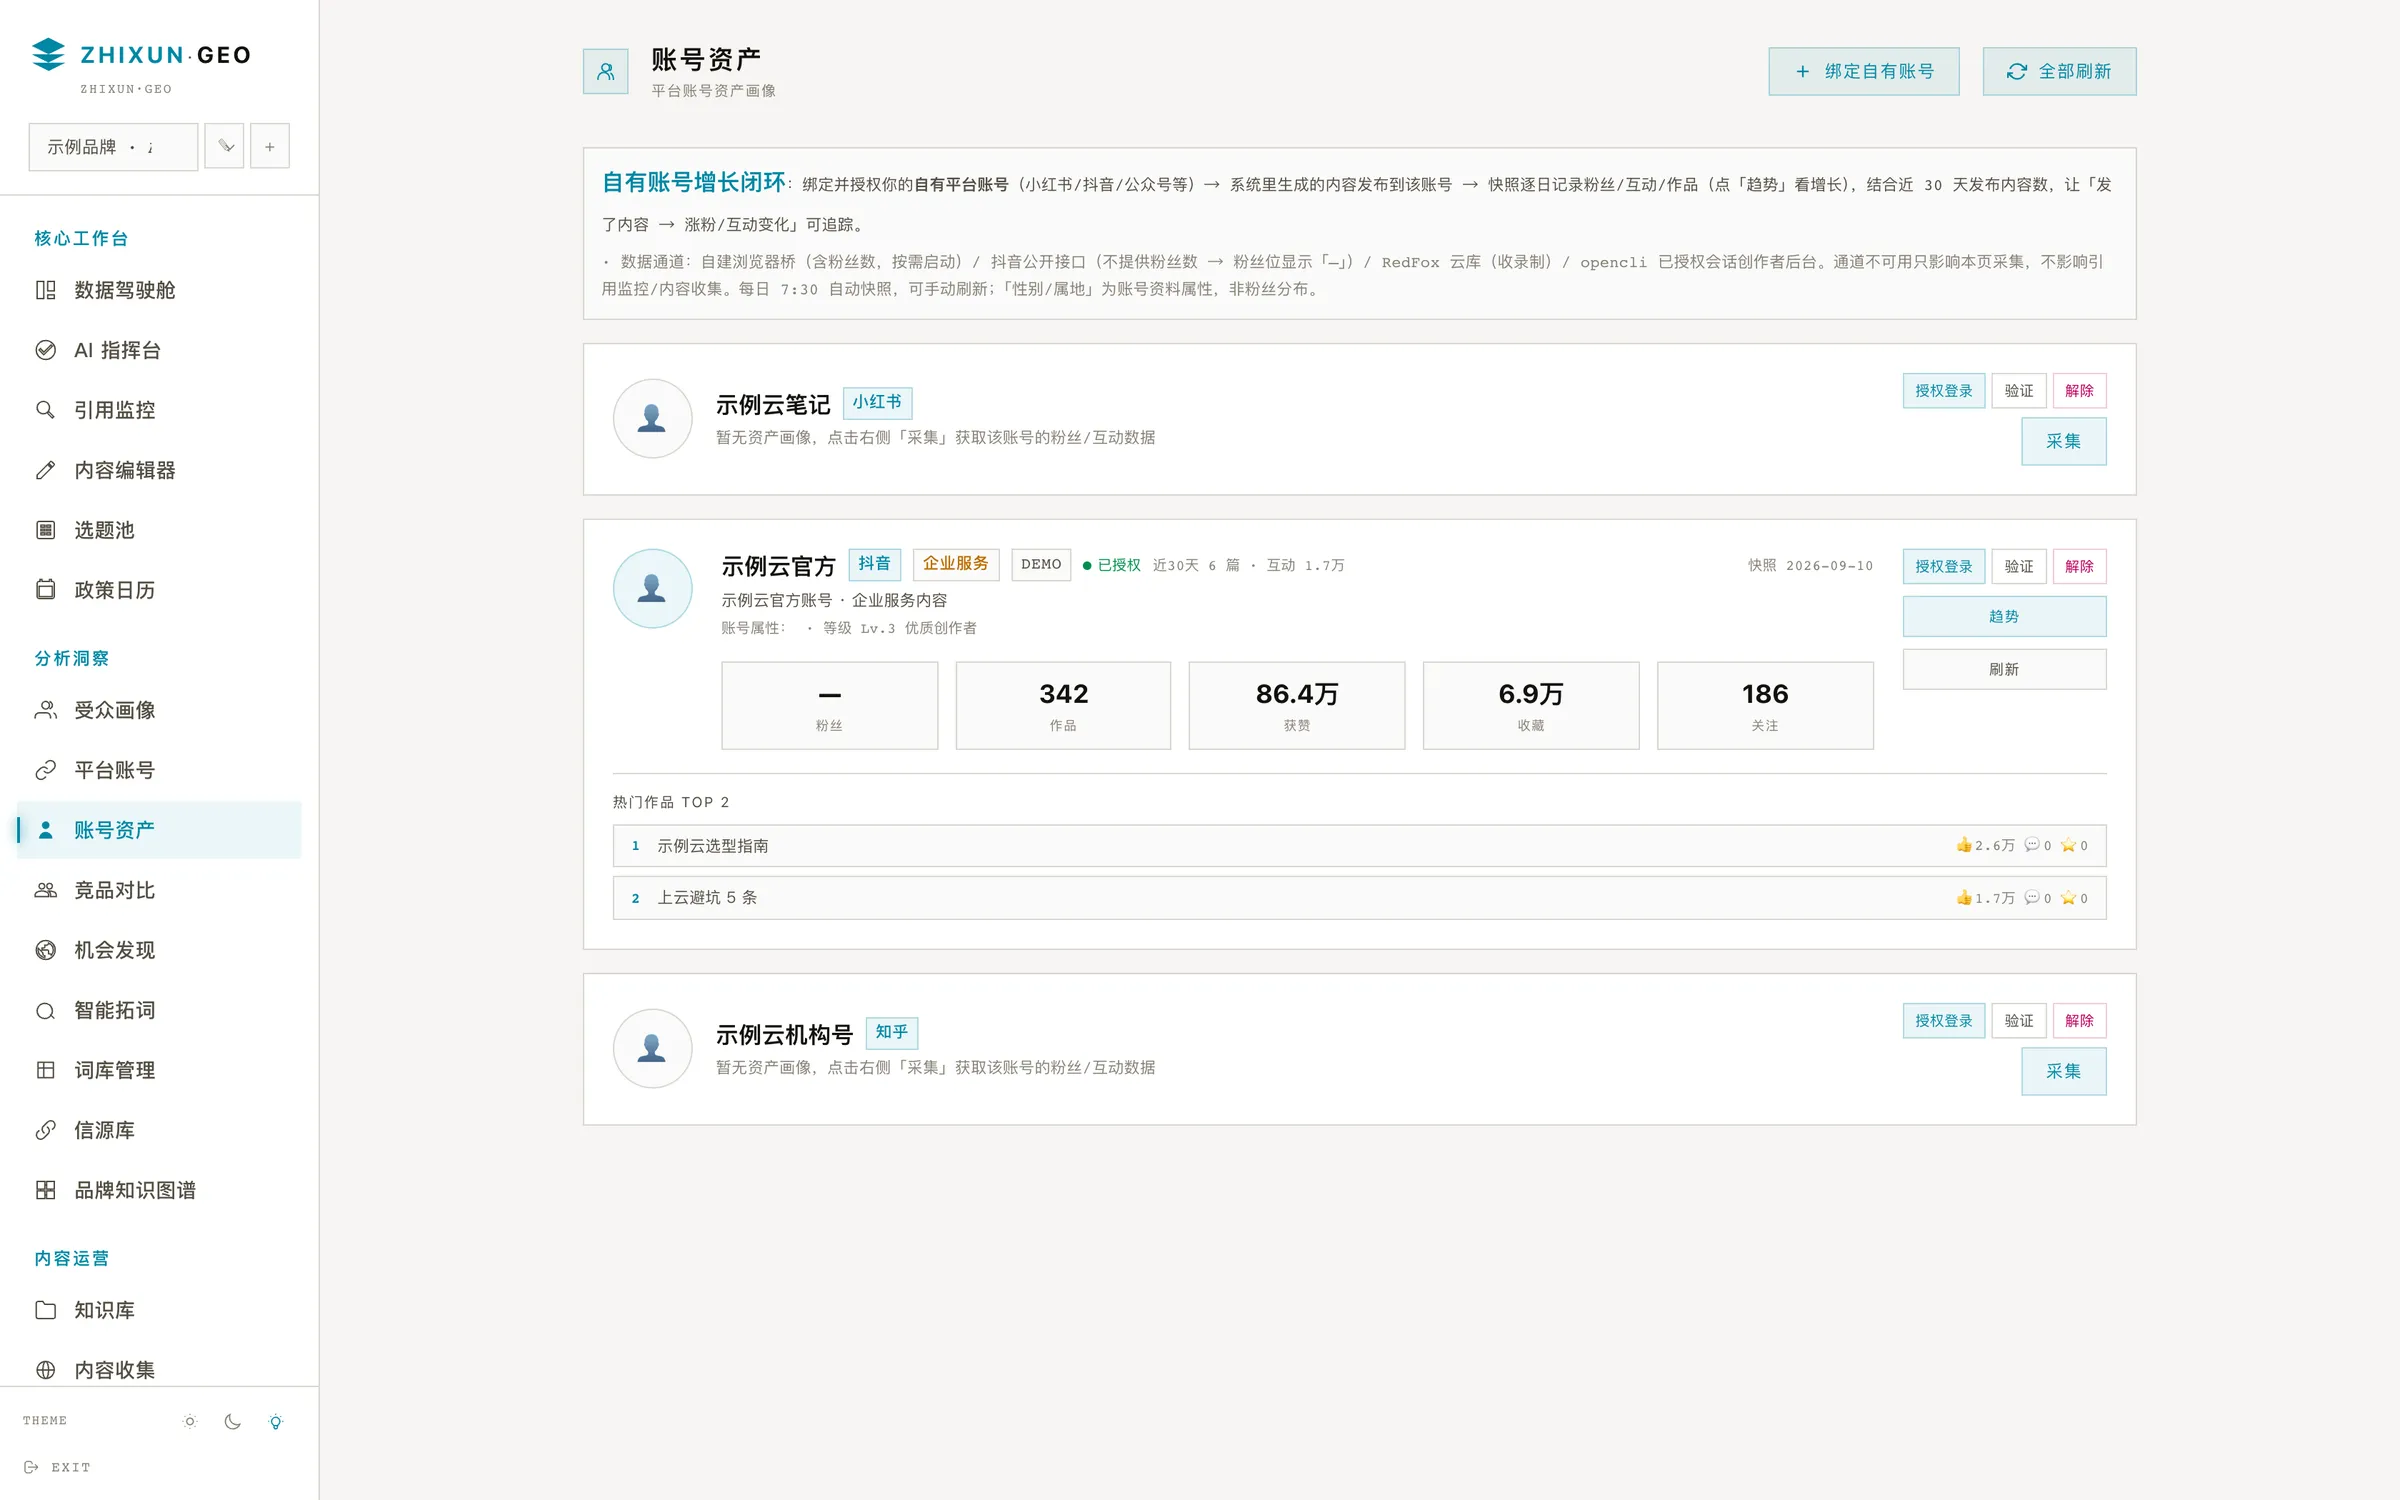
账号资产采集前的身份核对,是数据可信度的第一道闸门
行业普遍做法
采集账号资产时按账号名或链接直接抓取,抓回什么就存什么,很少校验这个账号到底是不是该品牌的;遇到同名号、搬运号,或者平台改版导致字段错位,数据错了也很难发现,错值会一路带进后面的统计、对比与效果报告里;更麻烦的是各平台字段口径不一,同一指标横向比较也未必成立。
知寻 GEO 做法
账号资产走双通道采集:先走主通道拿公开数据,主通道查不到时启用备援通道补粉丝等后台字段;备援通道必须先过身份核对,绑定昵称与登录账号不一致就拒绝出数,登录名与创作者后台昵称不一致再核一次,防止把同名号或别的账号的数据,误算成品牌自己的 AI 可见度。
补充:主通道与备援通道(opencli)都要过同一套身份核对——绑定昵称须一致,昵称为空时以登录账号为准,不因通道不同而放宽。
名字都对不上,数据再漂亮也不算数。
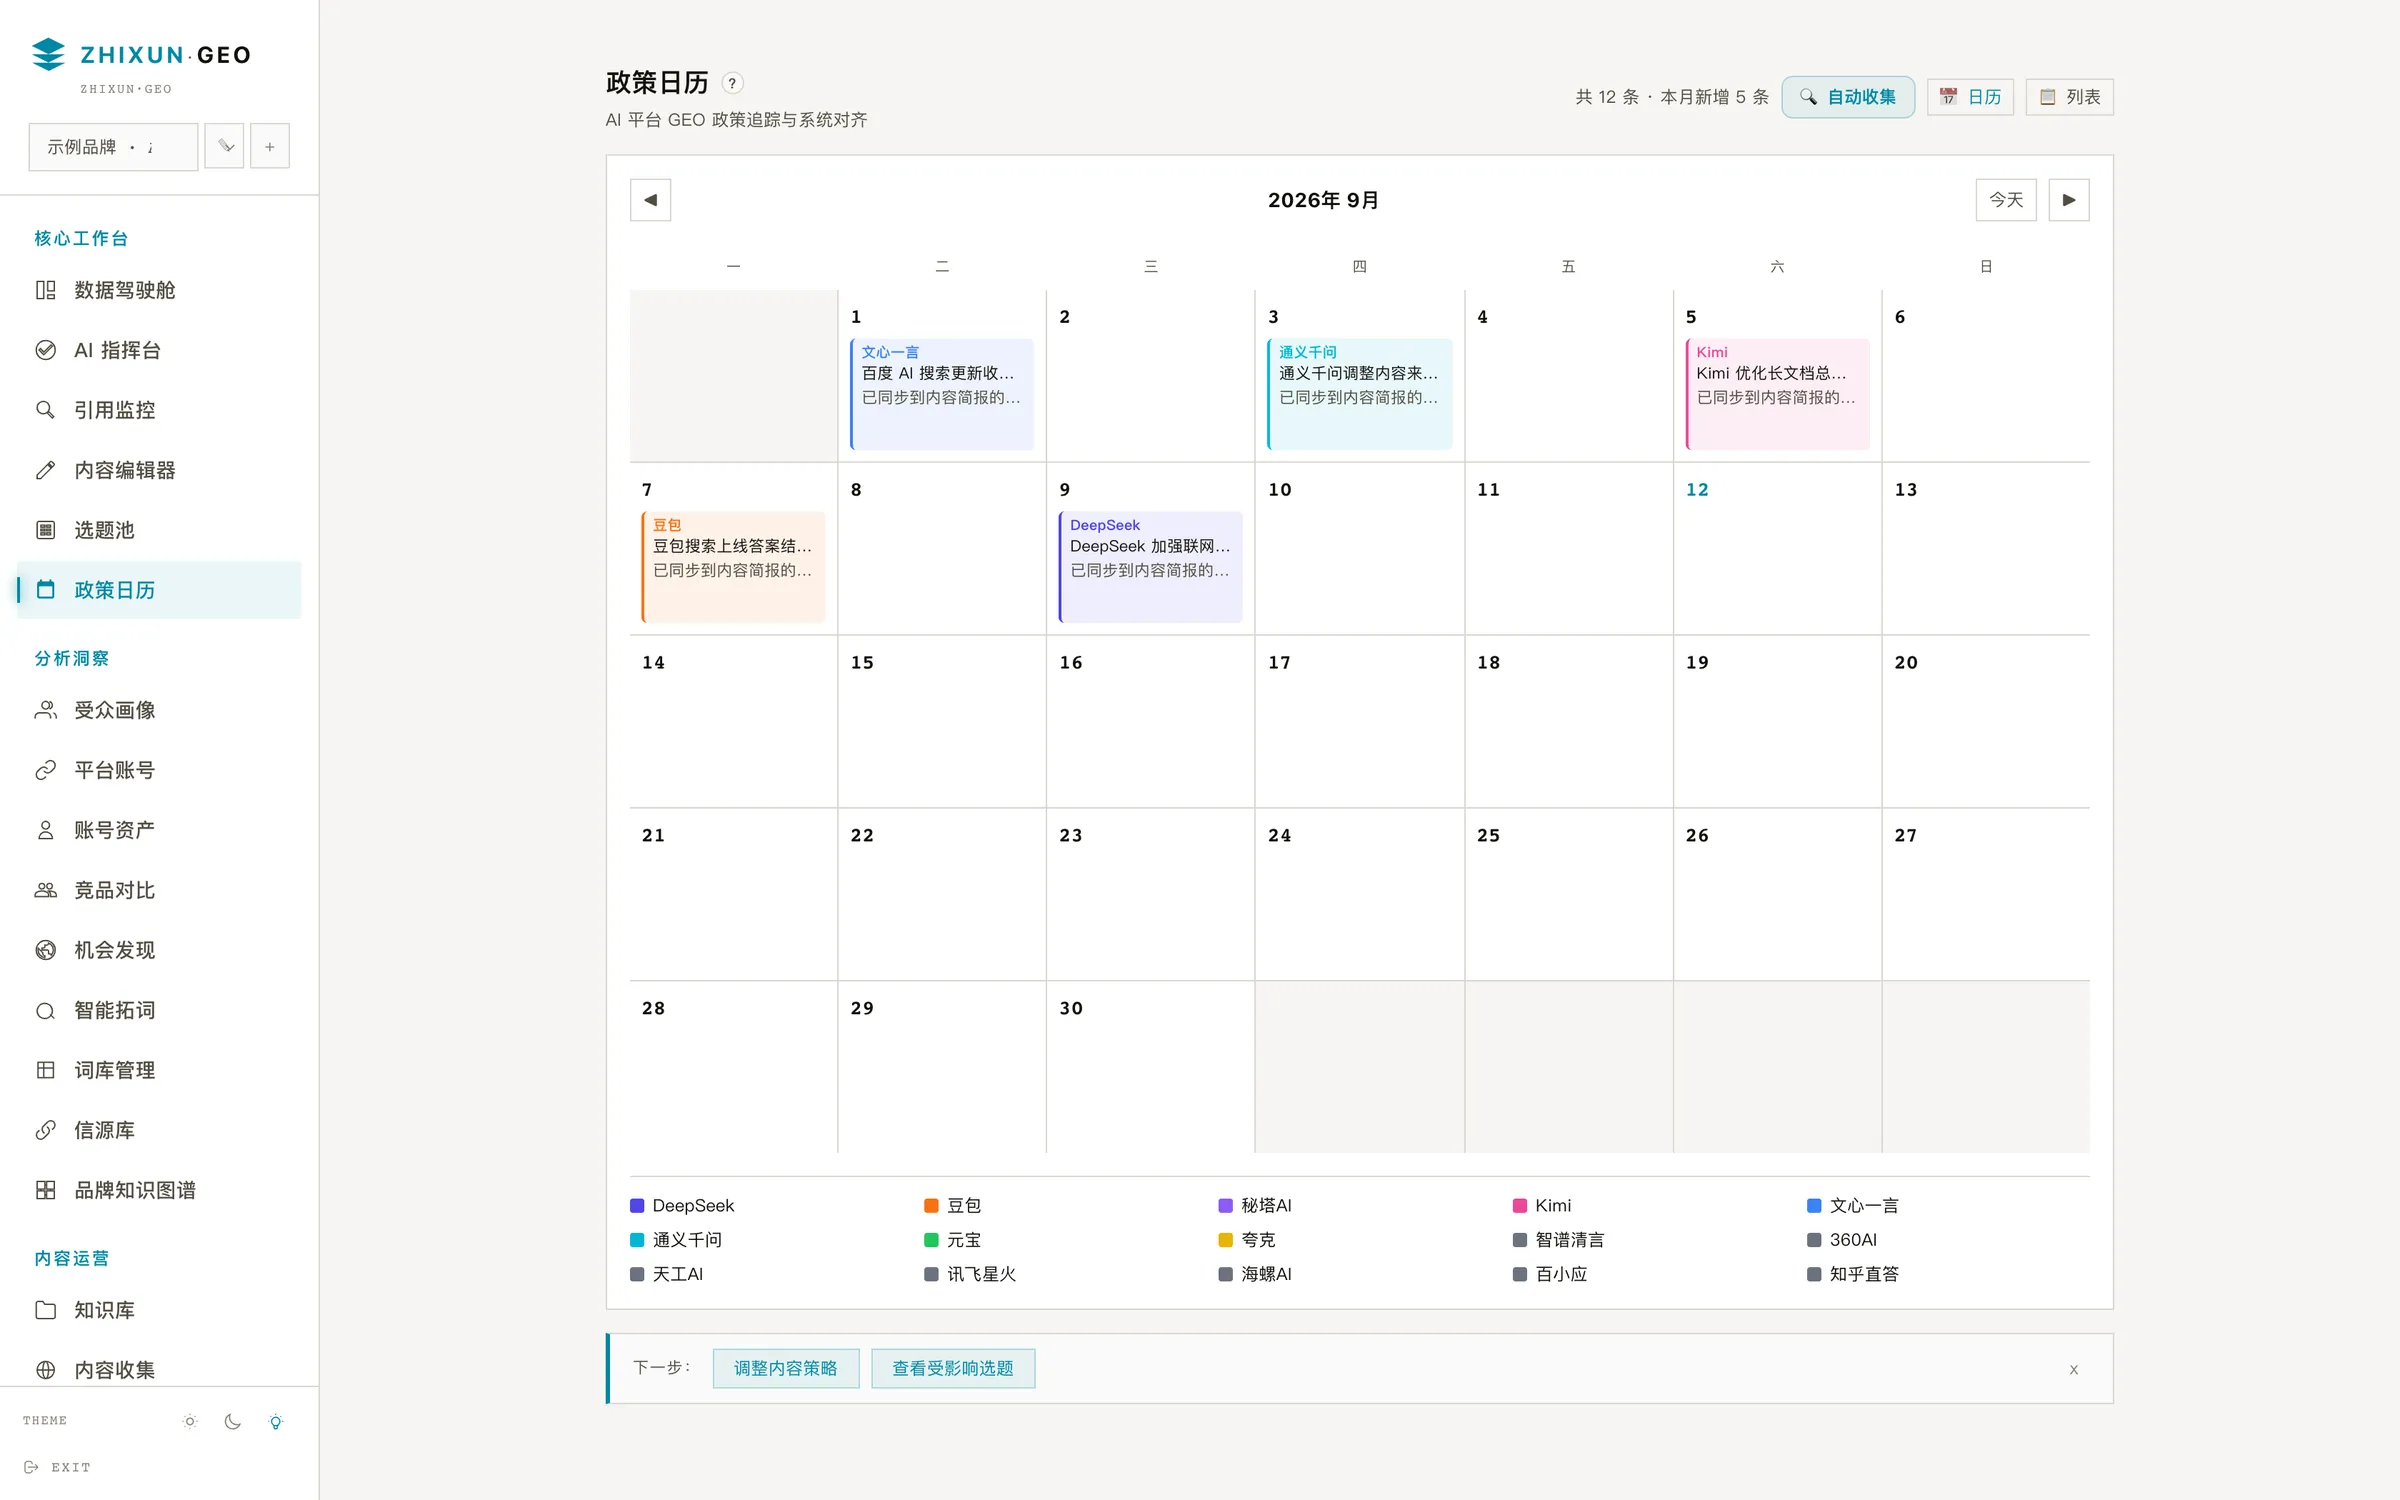
我们追的不是政府法规,是 AI 平台的游戏规则
平台改一次引用策略,你的内容打法当天就该跟着改
行业普遍做法
做行业新闻或政府政策日历,把平台公告、监管动态抓下来按时间排好,读完知道「发生了什么」;但公告对业务意味着什么、要不要改内容、该改哪个环节、影响多大,通常留给运营自己判断,信息与动作之间是断开的,也没有影响分级;公告还常与自家内容打法脱节,错过调整窗口。
知寻 GEO 做法
每周一自动扫描各 AI 平台公告,用搜索发现新规则后交给模型分析成结构化记录:影响等级、影响维度、我方应对措施、需调整的功能清单、关联受影响功能与置信度;置信度达到零点八且影响为低或中才自动入库,高影响转待复核并触发站内预警,同一条政策不重复告警。
补充:每条规则都落成结构化记录——影响等级、影响维度、我方应对措施、需调整的功能与置信度;置信度不足或影响为高时转待复核并触发站内预警。
知道规则变了,和知道该改哪一步,是两件事。
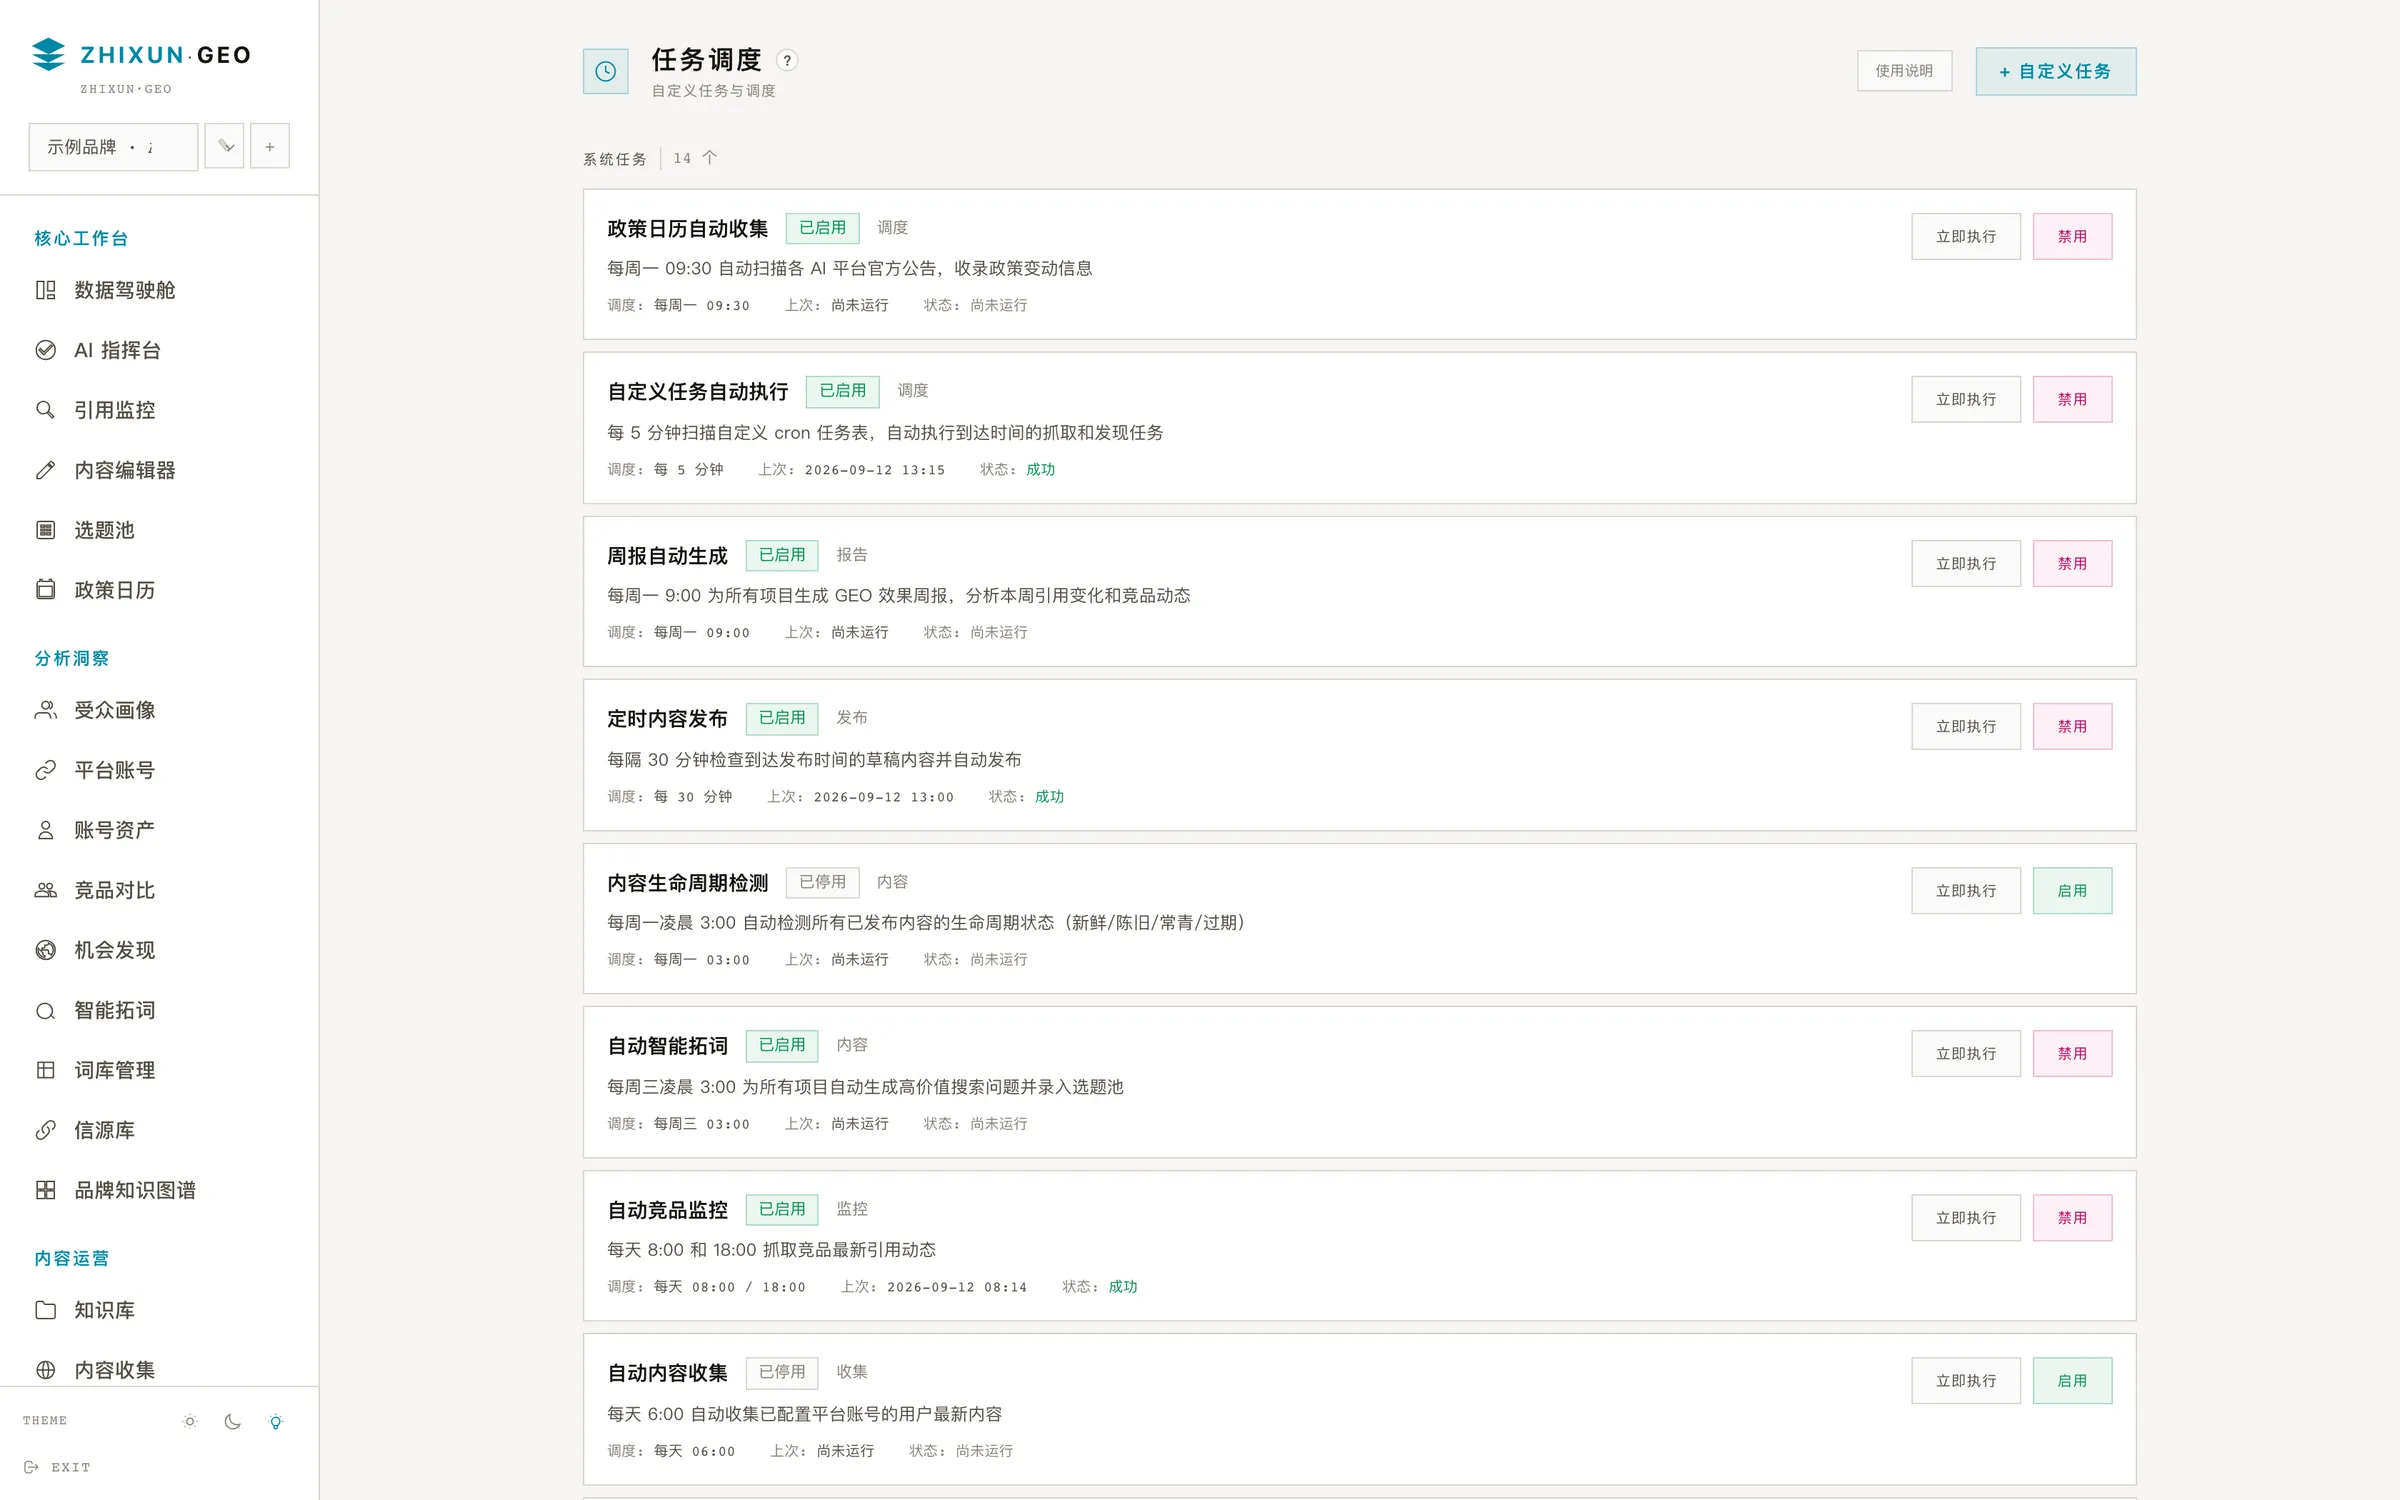
运营改一个时间,不用等开发发版
调度配置存在数据库里,由常驻守护进程扫表执行
行业普遍做法
定时任务写在代码或者配置文件里,改频率要开发改代码再发版;想看某次有没有跑、上次跑成没成,只能去翻服务器日志;服务重启后调度状态容易丢失,页面上显示的配置和真实在跑的任务经常对不上,没人敢保证显示的就是事实,出了问题也难定位是哪一次调度漏了。
知寻 GEO 做法
任务调度不写死在代码里,以数据库 task_schedule 表为准:常驻守护进程每二十秒扫表,按 cron 表达式判断到点执行,页面改启用状态或时间写库即生效、重启不丢配置;每次执行的开始时间、结束状态、任务号都落库,迟到十五分钟内按宽窗补跑、不永久跳过;每个项目的每个自动任务还能单独开关。
补充:调度唯一真相是数据库里的 task_schedule 表,由常驻守护进程按固定间隔扫表执行——页面上看到的就是实际在跑的,不存在「配置与运行不一致」。
无人值守,但不失控——对外动作始终留人工确认闸门。